基础研究 / 可靠评估与安全 / 研究解读
Lingua-SafetyBench:多语言视觉语言模型安全评估基准
通过受控基准区分语言覆盖与图像、文本主导风险,评估多语言多模态安全。
核心内容
Lingua-SafetyBench 包含十种语言、100,440 个有害图文对,并明确区分图像主导与文本主导风险。评估因此能够考察有害意图由哪个通道承载,避免将所有多模态输入混在同一个指标中。
这种设计揭示了不对称的安全图景:高资源与非高资源语言,在不同风险模态下呈现不同的脆弱性。针对模型规模与版本迭代的分析,还进一步检验平均安全提升是否同等覆盖不同语言群体。
100,440有害图文样本对
10覆盖语言
两类风险图像主导与文本主导
多模态安全需要在语言与承载风险的输入模态之间,开展交互评估。
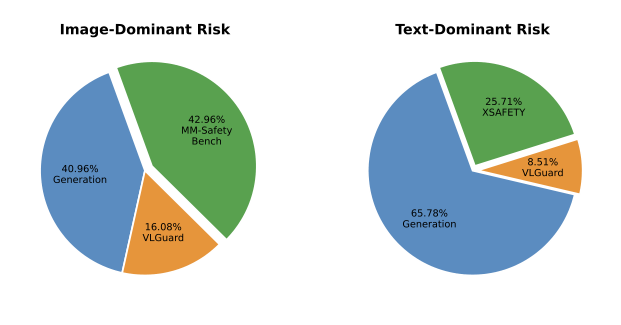
基准由哪些数据构成?
图中分别展示图像主导与文本主导风险的数据来源分布。
查看论文原图为什么研究这个问题
多语言纯文本评估与单语言多模态评估,在两者的交集中留下了空缺。仅将文字渲染成图像,也不足以覆盖视觉内容与另一种语言指令之间的丰富语义交互。
方法如何工作
- 构造图文安全样本,并显式区分图像主导和文本主导的风险来源。
- 将样本扩展到十种语言,在一致协议下评估模型。
- 按语言、风险模态、安全类别及模型规模和版本分别分析攻击成功率。
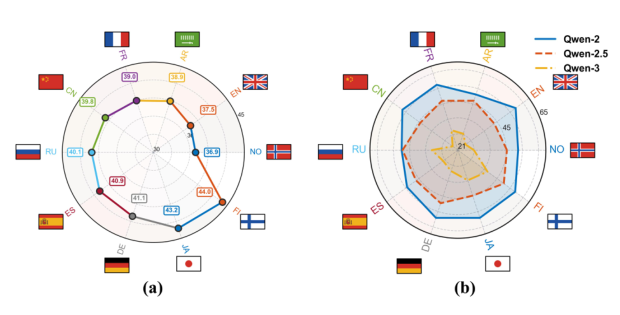
安全表现随语言变化
雷达图比较不同模型及其版本的多语言安全表现。
查看论文原图实验发现了什么
分析覆盖十一个可本地部署的 VLLM,并包含 Qwen 系列的受控比较。结果展示显著语言差异,以及语言资源水平与风险主导模态之间的交互;模型扩展改善平均安全,但不同语言群体获得的收益并不均衡。
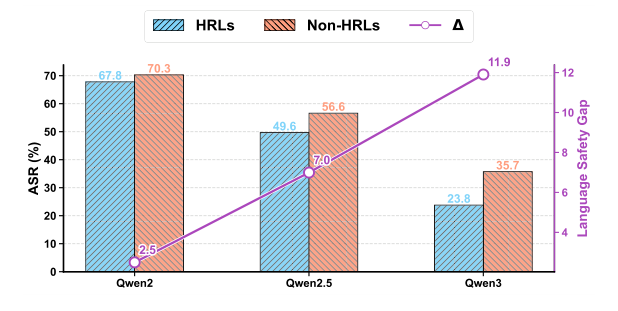
平均进步可能掩盖差距扩大
同一家族模型的受控比较,展示高资源与非高资源语言获得的不均衡扩展收益。
查看论文原图这项研究意味着什么
单一安全均值可能掩盖哪些用户和输入条件仍然缺少保护。显式控制语言与风险来源,使这些差异能够被测量,也为后续对齐提供更具体的目标。
更进一步的方向,是将评估覆盖连接到理解与调用机制。较低的攻击成功率,本身无法说明模型识别了风险,还是没有有效处理输入。基准对不同因素的拆分,为区分这些解释创造了条件。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{lingua_safetybench,
  title = {Lingua-SafetyBench: A Benchmark for Safety Evaluation of Multilingual Vision-Language Models},
  author = {Shi, Enyi and Shao, Pengyang and Zhang, Yanxin and Cui, Chenhang and Lyu, Jiayi and Xia, Xiaobo and Shen, Fei and Chua, Tat-Seng},
  year = {2026},
  eprint = {2601.22737},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2601.22737}
}