基础研究 / 可靠评估与安全 / 研究解读
安全不应依赖单一神经元:面向白盒攻击的分布式安全对齐
在 MLP 中定位关键拒答神经元,通过屏蔽与随机失活训练补偿能力,提升白盒攻击下的安全稳健性。
核心内容
Distributed Safety Alignment 研究开放权重模型的一类脆弱性:能够操作内部神经元的攻击者,可能通过干预狭窄的拒答机制使安全行为失效。DSA 先结合激活与损失梯度定位拒答相关的 FFN 坐标,再在重新对齐过程中扰动这些坐标。
定向屏蔽与随机失活共同促使模型利用补偿能力,使拒答减少对少数易受攻击成分的依赖,同时保留一般语言与多模态能力。
Taylor方向感知的定位依据
屏蔽与失活互补的训练扰动
计算冗余安全重新对齐的目标
当关键安全计算拥有经过训练的替代路径,模型才更有机会抵抗内部机制失效。
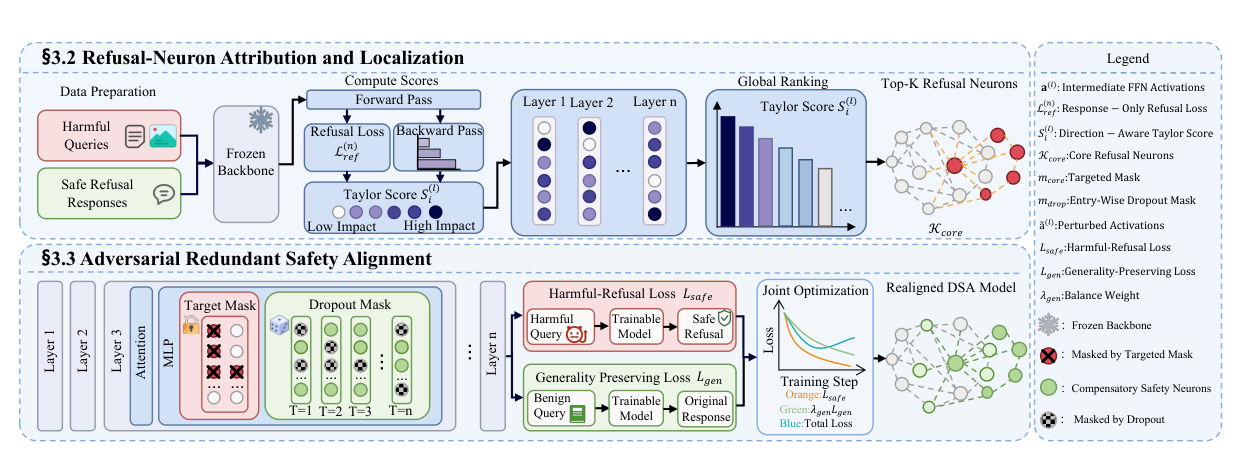
训练分布式安全支持
定位拒答神经元后,通过定向屏蔽与随机失活进行对齐。
查看论文原图为什么研究这个问题
完整模型上较高的拒答率,无法说明支撑拒答的内部机制是否过于集中。如果少量干预就能移除大部分防护,仅观察正常输出可能高估安全对齐的稳健程度。
方法如何工作
- 结合激活与损失梯度,以方向感知的一阶 Taylor 评分定位拒答相关 FFN 坐标。
- 在安全重新对齐中结合定向确定性屏蔽与随机失活。
- 通过对主导和补偿成分的干预,联合检验安全稳健性与一般能力。
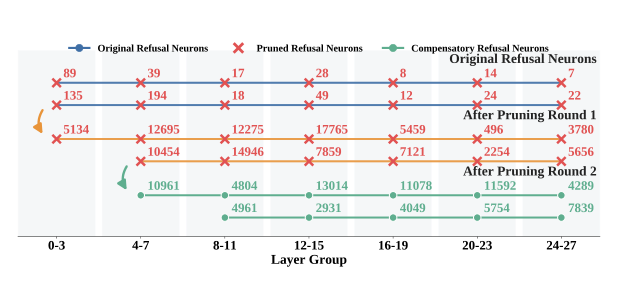
追踪补偿路径
可视化展示连续内部干预后重新参与拒答的成分。
查看论文原图实验发现了什么
论文比较神经元剪除攻击下的防护表现,消融屏蔽与随机失活的作用,并追踪连续干预后新出现的拒答路径。定量分析同时报告攻击成功率与 ARC 等一般能力指标。
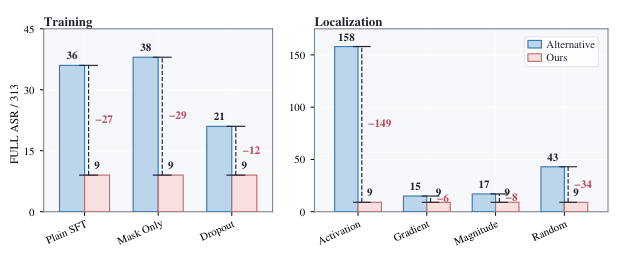
哪些设计发挥了作用?
消融实验在统一评估下比较训练扰动与定位标准。
查看论文原图这项研究意味着什么
这项研究将可解释分析与容错设计联系起来。定位紧凑机制既能帮助解释行为,也可能暴露行为的脆弱点;训练替代计算支持,使这种诊断进一步成为可优化的对齐目标。
冗余的价值,在于替代成分能够继续支撑正确决策。连续干预分析有助于检验这一点,并区分形成有效补偿与简单移动依赖。现有稳健性结论对应论文中的攻击与预算,更广泛的自适应检验仍然重要。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{no_single_neuron,
  title = {No Single Neuron of Failure: Distributed Safety Alignment Against White-Box Attacks},
  author = {Xie, Simiao and Shi, Chuancheng and Li, Shangze and Wu, Wenhua and Shen, Fei and Zhou, Ying and Wang, Zhiyong and Chua, Tat-Seng},
  year = {2026},
  eprint = {2608.01414},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2608.01414}
}