基础研究 / 能力激发与迁移 / 研究解读
OPD-V:以模态平衡引导视觉同策略自蒸馏
通过视觉教师对照,选择获得更强图像证据支持的自蒸馏词元。
核心内容
OPD-V 研究视觉同策略自蒸馏中的模态失衡。教师即使置信度较高,也可能主要依赖文本上下文,使额外视觉信息未被充分使用。方法在相同文本与学生生成前缀下,对比放大图像的正教师和遮蔽图像的负教师。
两类教师的词元 logit 差构成模态平衡信任区域,将蒸馏集中到正向视觉条件提供更强支持的词元,使监督选择与证据利用联系起来。
6评估基准
4多模态骨干
5后训练方法
有价值的蒸馏监督,也应考虑教师如何使用视觉证据。
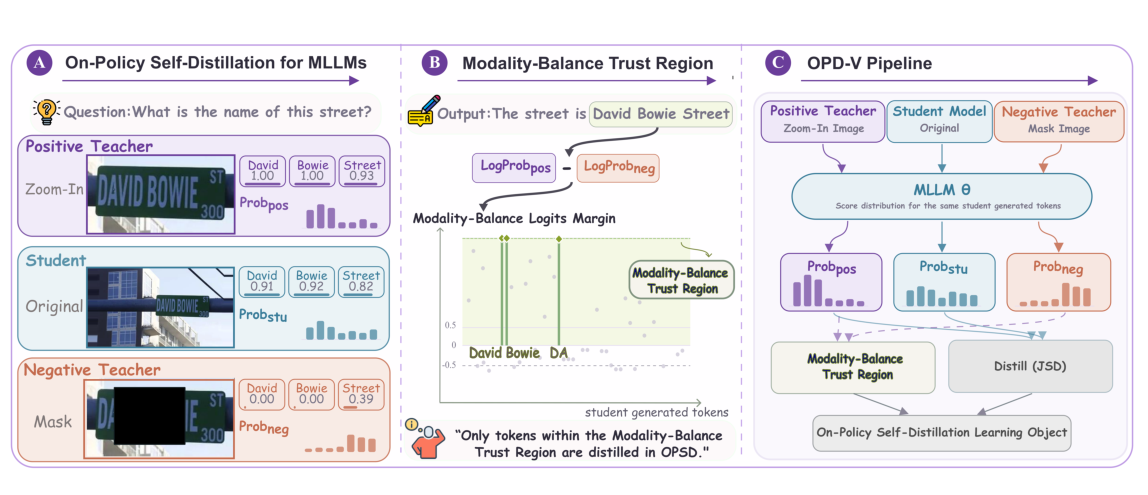
选择获得视觉支持的更新
正负教师条件共同定义同策略蒸馏的词元级信任区域。
查看论文原图为什么研究这个问题
额外信息能否改善训练,取决于教师是否实际使用这些信息。对于多模态模型,置信度和正确性本身,未必足以说明某个推理信号是否依赖图像。
方法如何工作
- 让原图学生、放大图像正教师与遮蔽图像负教师,对同一学生生成词元进行评分。
- 根据正的模态平衡 logit 差,选择同策略信任区域。
- 在选定词元上进行正教师引导的 Jensen–Shannon 蒸馏,并比较效果与训练开销。
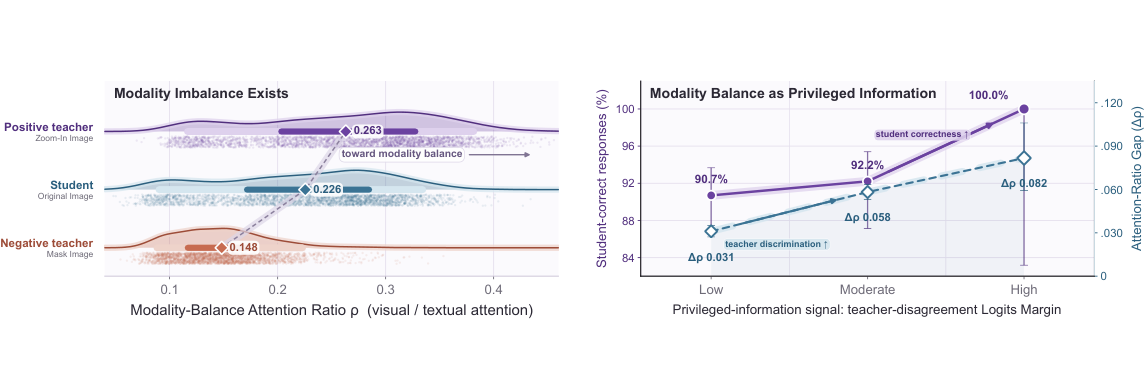
将模态平衡作为诊断信号
分析连接视觉注意力平衡、教师行为与所提出的额外监督信息。
查看论文原图实验发现了什么
实验覆盖六个基准、四类多模态骨干与五种后训练方法,同时分析注意力平衡、教师行为、训练动态、模块消融和每步墙钟时间,检验监督选择标准在这些设置下的作用。
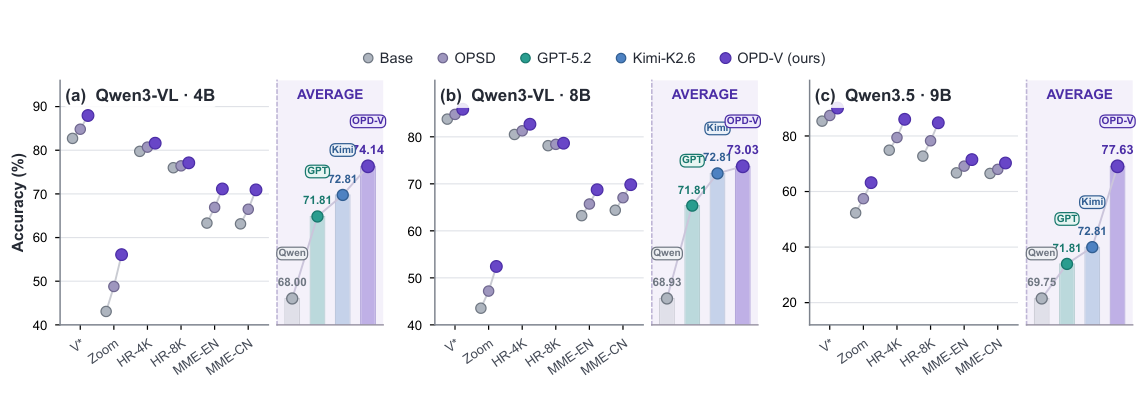
跨骨干比较
原图比较不同模型架构与后训练方法的基准准确率。
查看论文原图这项研究意味着什么
这项工作将监督质量与信息依赖联系起来。通过对照不同视觉条件,可以识别哪些教师支持与更充分的视觉输入相关,并让这种区分直接参与训练。
由此,评估与优化形成连接:对模态使用的诊断,进一步成为选择更新的依据。更广泛的问题,是这一标准在不同图像变换、任务与模型家族中,何时仍能稳定对应有用的证据。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{opd_v,
  title = {OPD-V: Visual On-Policy Self-Distillation with Modality Balance},
  author = {Aniri and Bi, Jinhe and Liao, Peng and Jin, Zengjie and Tresp, Volker and Shen, Fei and Ma, Yunpu and Chua, Tat-Seng},
  year = {2026},
  eprint = {2608.05131},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2608.05131}
}