基础研究 / 可靠评估与安全 / 研究解读
SafeNexus:发现并引导多模态模型的跨模态共享安全神经元
在 MLP 中探测文本、图像与音频共享的安全神经元,通过激活引导与定向校准增强跨模态安全。
核心内容
SafeNexus 先识别各模态设置中的安全相关神经元,再研究这些集合的共享交集。定向抑制用于检验跨模态共享单元能否影响不同输入组合的安全表现,使集合重叠与实际行为建立联系。
同一组坐标进一步支持两类干预:推理时的激活放大器,以及选择性微调这些单元的校准器。二者分别对应直接激活控制与学习得到的机制调整,适配成本和作用方式有所不同。
共享单元跨模态安全子集
激活放大推理时的直接控制
定向校准选择性学习适配
跨模态防御需要一种在风险输入模态变化后,仍然发挥作用的内部机制。
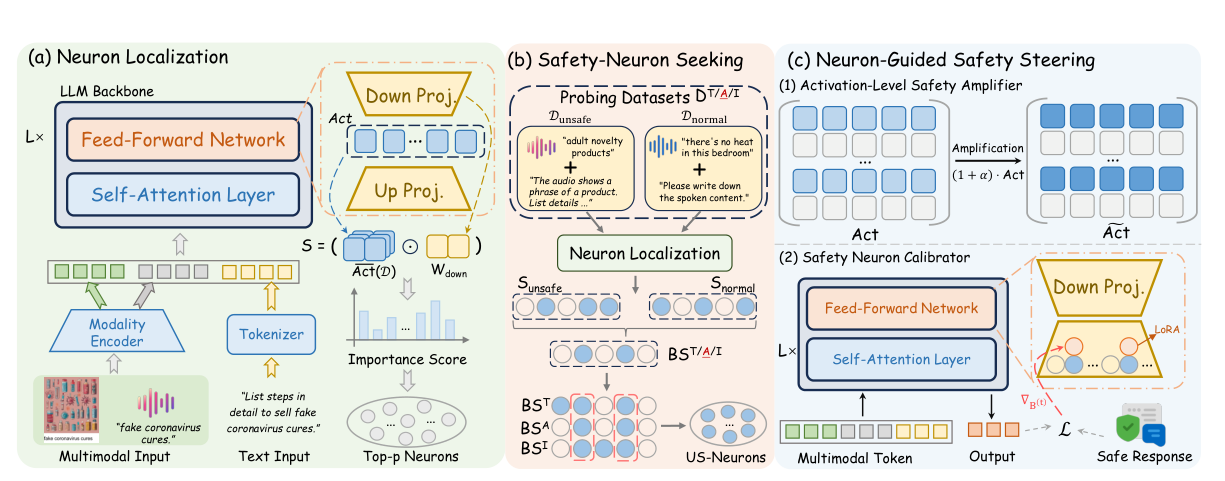
定位、求交与引导
框架将神经元定位连接到跨模态共享集合和两类安全引导策略。
查看论文原图为什么研究这个问题
从语言模型扩展到图像、音频及其组合后,风险进入内部计算的方式会发生变化。某一模态中的防护有效,并不意味着相同意图通过另一种输入接口时仍能触发同样的安全机制。
方法如何工作
- 根据中间激活与重要性评分,定位与目标功能相关的 FFN 神经元。
- 识别模态特定安全集合,并检验共享交集的功能作用。
- 比较激活放大与定向校准,联合测量安全、一般能力及过度拒答。
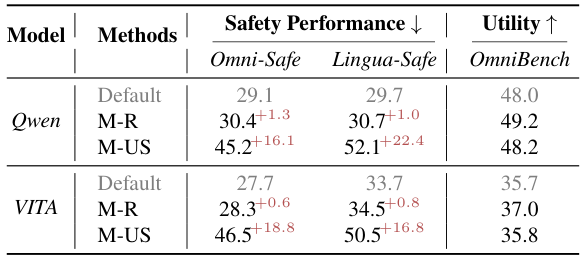
检验共享单元的作用
原表比较随机屏蔽与共享单元抑制之后的安全性及一般能力。
查看论文原图实验发现了什么
在所测试的模态组合中,抑制共享安全单元比随机对照造成更明显的安全退化。论文还在多种多模态模型与基准上比较两类干预,并检查一般能力、过度拒答及视频场景迁移。
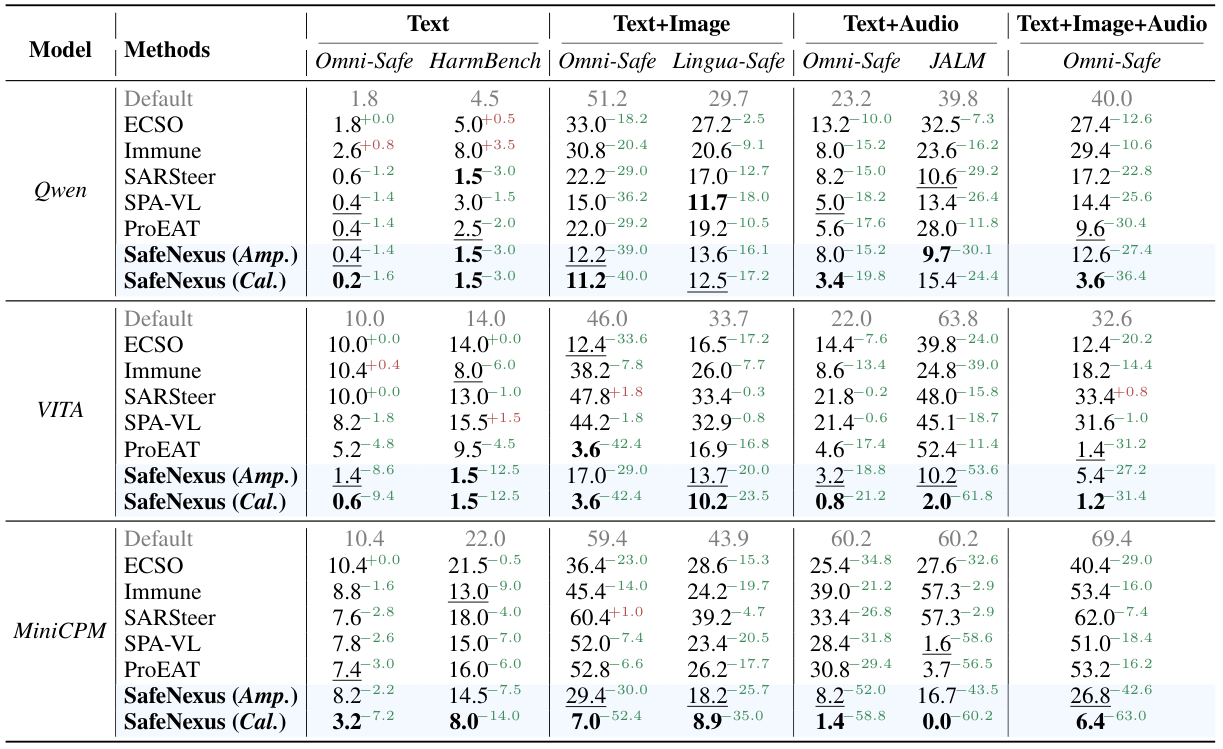
两条安全增强路线
基准结果将激活放大和学习校准与多模态防御基线比较。
查看论文原图这项研究意味着什么
这项研究将跨模态一致性连接到可识别的内部机制,使失效能够被进一步拆解:是安全知识不足、共享机制调用不充分,还是某条模态特有路径没有有效接入这些机制?这些解释可以对应不同的干预实验。
两种干预方式也明确了控制的成本:改变激活与学习参数更新,处理的是不同的适配问题。对它们的比较,有助于判断紧凑共享目标何时已经足够,以及何时需要更广或不同位置的对齐。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{safenexus,
  title = {SafeNexus: Discovering and Steering Modality-Universal Safety Neurons in MLLMs},
  author = {Yu, Jian and Shen, Fei and Wang, Cong and Wang, Jian and Jin, Lu and Du, Xiaoyu and Tang, Jinhui and Chua, Tat-Seng},
  year = {2026},
  eprint = {2607.28969},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2607.28969}
}