基础研究 / 可靠评估与安全 / 研究解读
Safety Kernel:面向跨语言防御的机制驱动安全对齐
在 MLP(FFN)模块输出中探测跨语言共享安全神经元,将 LoRA 更新限定在对应的安全核心坐标。
核心内容
Safety Kernel 识别跨语言共享的紧凑安全神经元坐标集合。SCAR 评分结合平行良性与有害提示上的激活响应及安全对比,再将各语言候选集合求交,得到安全核心。
抑制与激活状态迁移实验用于检验其功能作用。随后,SK-Masked LoRA 将适配限制在这些坐标对应的 FFN 输出维度,使机制诊断能够直接约束参数更新范围。
SCAR逐语言定位评分
共享核心跨语言集合交集
受限 LoRA限定坐标的参数适配
跨语言对齐可以围绕一个共享内部目标组织,并在微调前先检验其行为作用。
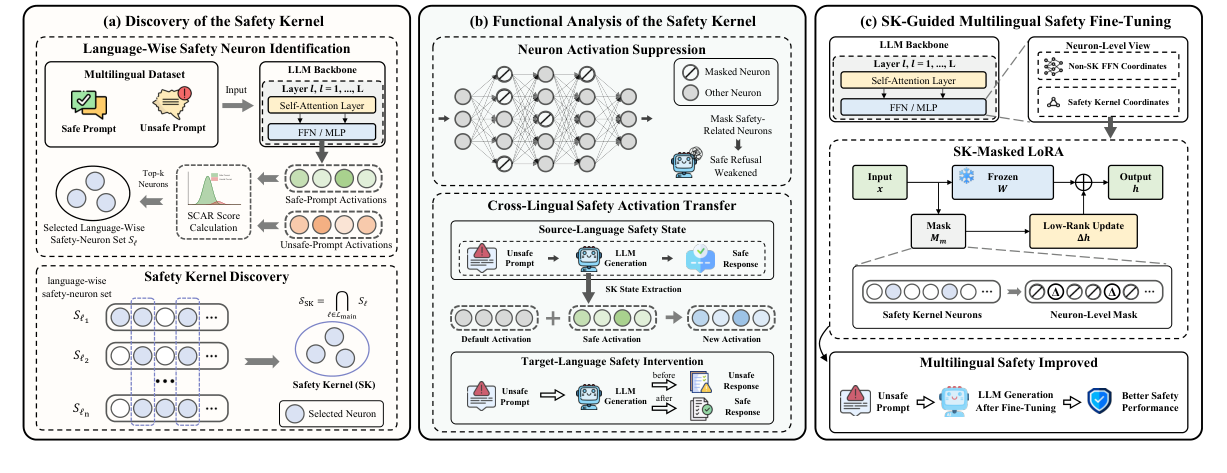
从核心发现到受限适配
框架连接逐语言评分、共享集合验证与安全核心引导的 LoRA 更新。
查看论文原图为什么研究这个问题
外部监督能够改善多语言安全,却未必揭示安全行为通过哪些内部计算发生迁移。共同的机制目标,有助于连接用于发现的语言、训练修改的位置,以及最终接受评估的语言。
方法如何工作
- 使用多语言平行良性与有害提示,计算各语言的 SCAR 评分。
- 对候选神经元集合求交,并通过抑制与激活状态迁移检验安全核心。
- 将 LoRA 适配限定在选定 FFN 输出维度,联合评估跨语言防护与能力保留。
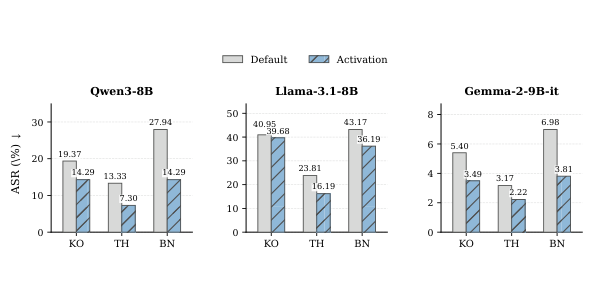
改变安全核心的激活状态
比较通过核心坐标迁移拒答相关激活状态后的安全表现。
查看论文原图实验发现了什么
论文结合紧凑性测量、屏蔽与激活状态干预,并在防御比较中纳入未参与核心发现的语言。其他分析进一步考察选择与更新范围、核心的语言组成和一般能力变化。
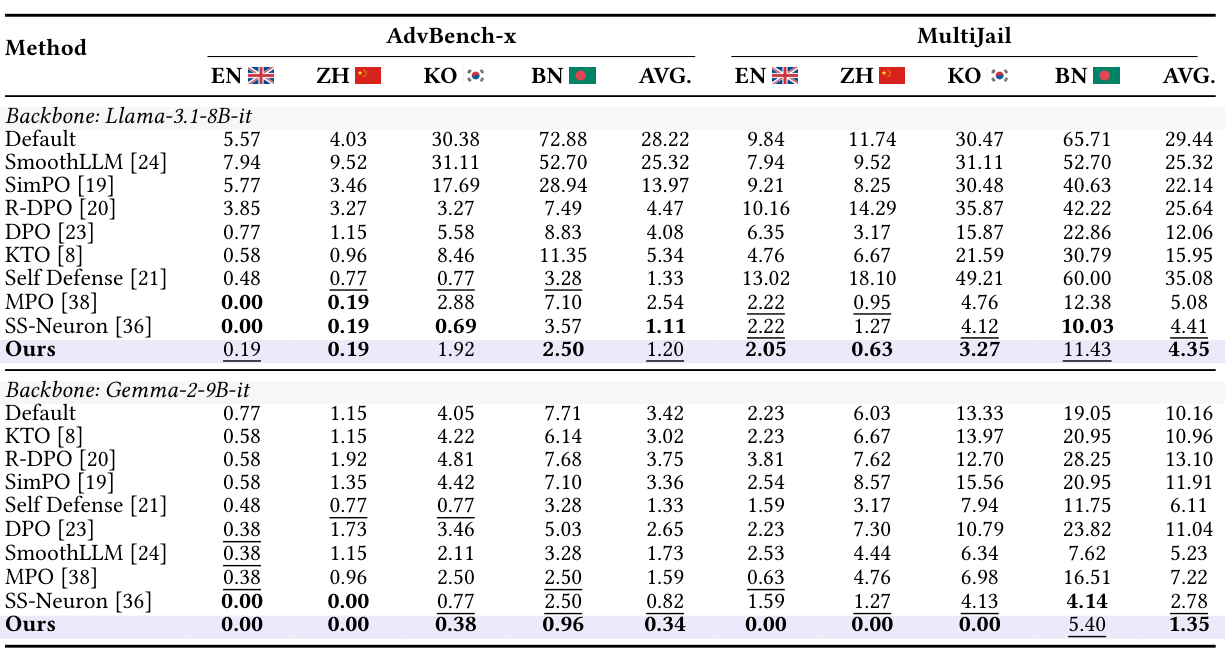
跨语言防御结果
原表比较不同语言和对齐基线下的攻击成功率。
查看论文原图这项研究意味着什么
这一框架建立了较清楚的观察—控制链条:先识别共享集合,检验改变它会产生什么影响,再沿其坐标进行适配。多语言迁移因此能够连接到内部解释,而不仅体现为一次分数提升。
安全核心由发现过程与语言集合定义。研究其组成和未见语言迁移,有助于明确紧凑共享目标在什么条件下能够支撑有效干预。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{safety_kernel,
  title = {Safety Kernel: Mechanistic Alignment for Cross-Lingual Defense in LLMs},
  author = {Xie, Chengyu and Shen, Fei and Miao, Shuyi and Feng, Yue and Yu, Jian and Shao, Pengyang and Tian, Yijun and Du, Xiaoyu},
  year = {2026},
  eprint = {2610.24614},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2610.24614}
}