TraceRouter++:通过最优传输重对齐因果语义路由
追踪安全相关的因果传播路径,并通过逐坐标最优传输近似,将选中路由的激活分布柔性重对齐至安全参考分布。
核心内容
不安全行为可能依赖跨层传播的计算路径,而非某一个孤立神经元。TraceRouter++ 在识别安全相关路径后,进一步调整这些路径上的激活分布,使其接近安全参考状态,并限制干预点上的扰动范围。
这一期刊扩展在“发现—追踪—重对齐”的框架中加入最优传输驱动的柔性干预。具体实现采用可计算的逐坐标分位数映射,对齐的是选中坐标的边缘分布,并非直接求解一般的联合最优传输问题。
定位安全相关路径与设计激活修改方式,是安全干预中相互补充的两个问题。
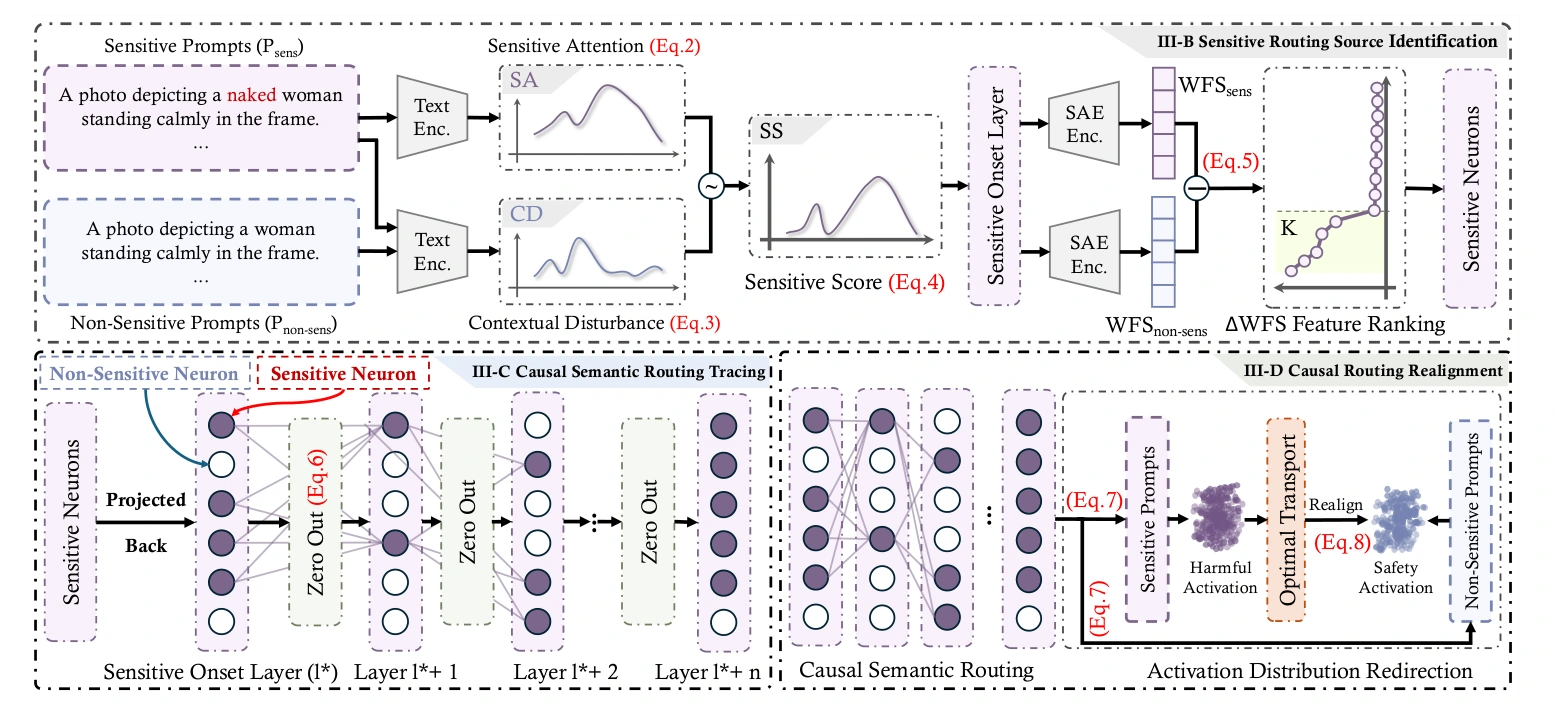
发现、追踪与重对齐
原始方法图连接敏感层定位、稀疏路由特征、因果影响追踪与最优传输重对齐。
查看论文原图为什么研究这个问题
局部特征抑制可能留下替代传播路径,也可能扰动正常能力。路径级干预需要同时回答两个问题:安全相关信息沿哪里传播,以及这些路径上的计算应如何改变。将路径定位与分布重对齐结合,使干预目标更加具体。
方法如何工作
- 发现敏感起始层:利用注意力差异定位干预起点,再用稀疏自编码器解析可解释的路由特征。
- 追踪下游因果影响:通过特征影响评分与干预证据,筛选参与安全相关计算的跨层传播路径。
- 执行柔性重对齐:以最优传输近似将选中激活的边缘分布映射至安全参考分布,并保持干预点未选中的坐标不变。
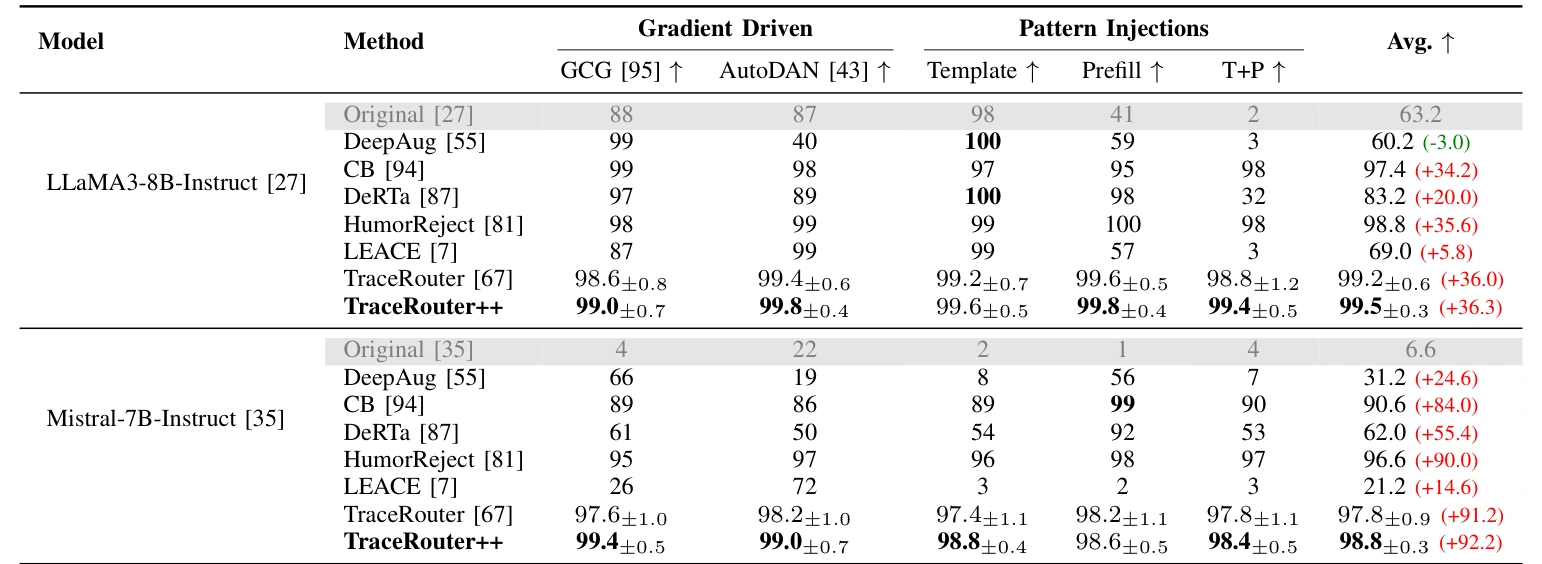
多类语言模型越狱攻击下的防御结果
原表报告防御成功率,两个被评估语言模型上的平均值分别为 99.5 ± 0.3% 和 98.8 ± 0.3%。
查看论文原图实验发现了什么
在论文报告的 LLM 攻击组合上,LLaMA3-8B-Instruct 与 Mistral-7B-Instruct 的平均防御成功率分别达到 99.5 ± 0.3% 和 98.8 ± 0.3%。评估还覆盖多模态大语言模型与扩散模型。
安全结果同时配有通用能力测量:上述两个语言模型在 Global-MMLU-Lite 上分别下降 0.4 和 0.6 个百分点。这些是实验中的能力代价,不能由“未选中坐标保持不变”这一局部性质直接推导。
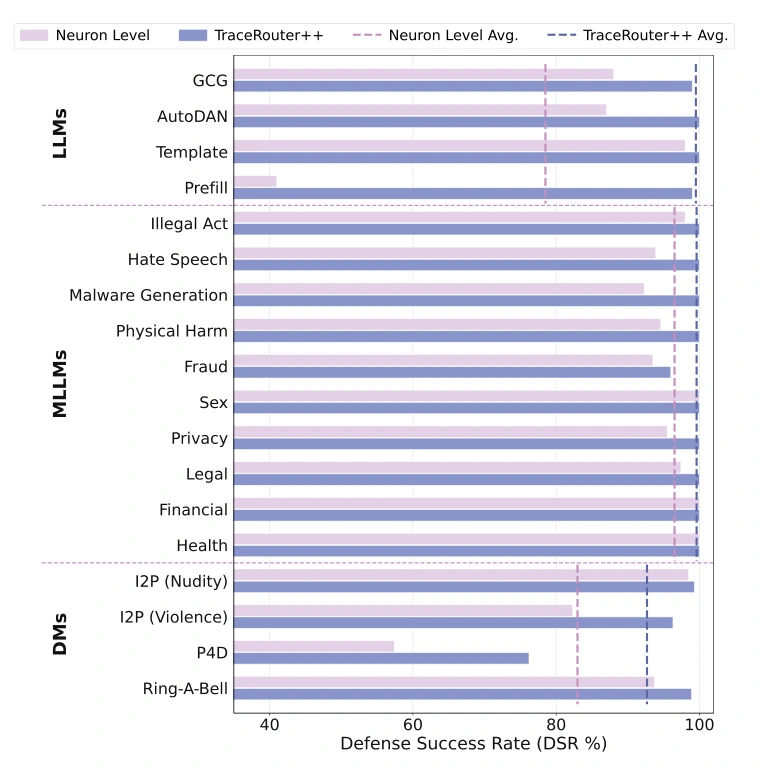
路径级与神经元级干预的比较
消融图在语言、多模态与扩散模型设置中,对比路由重对齐与孤立神经元抑制。
查看论文原图这项研究意味着什么
这项研究将安全控制表述为对信息流的塑形:因果追踪回答“干预哪里”,分布重对齐回答“如何改变”。二者的结合,使机制分析能够进一步转化为具有明确目标的模型控制。
方法的边界同样具有启发性:逐坐标传输通常不能保证联合依赖关系被完整保留,后续层也可能再次混合不同坐标。因此,局部干预的选择性需要与端到端的安全性、通用能力和过度拒答评估共同检验。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@article{tracerouter_plus_plus,
  title = {TraceRouter++: Causal Semantic Routing Realignment via Optimal Transport},
  author = {Shi, Chuancheng and Li, Shangze and Wu, Wenhua and Chen, Hengzhi and Shen, Fei and Zhuo, Li and Wang, Zhiyong and Chua, Tat-Seng},
  journal = {IEEE Transactions on Pattern Analysis and Machine Intelligence},
  year = {2026},
  doi = {10.1109/TPAMI.2026.3747849},
  url = {https://doi.org/10.1109/TPAMI.2026.3747849}
}