应用研究 / 视频取证 / 研究解读
V-FIND:揭示视频伪造检测器中的内在取证知识
在冻结视频伪造检测器中定位紧凑的潜在锚点神经元,提取可复用的取证信号。
核心内容
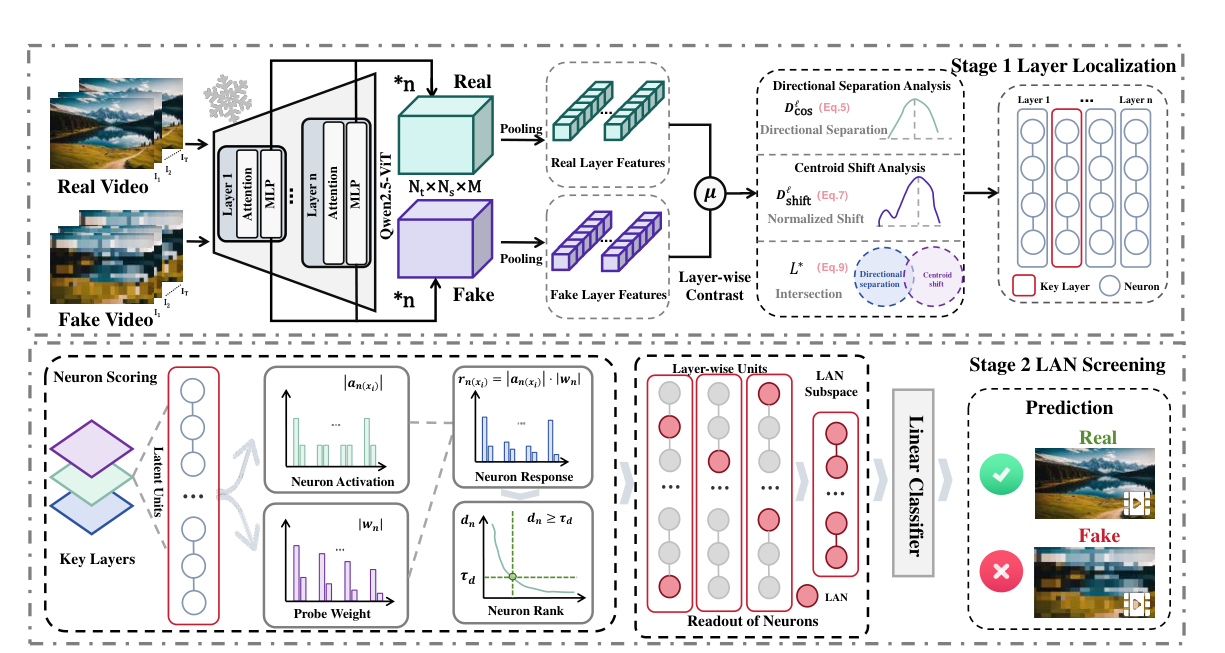
V-FIND 追问:不重新训练骨干,能够从视频检测器中提取多少取证能力?方法先定位能够区分真实与合成视频的关键层,再识别持续携带判别信号的稀疏潜在锚点神经元,构成紧凑的取证子空间。
原骨干保持冻结,仅训练轻量线性分类器读取选定子空间。外部基准与神经元干预共同检验这些信号是否可复用、是否与检测行为存在功能联系。
冻结骨干保留原视频表征
线性读出读取紧凑取证子空间
激活交换检验单元的功能作用
检测器的取证知识,可以通过更换读出后仍然有效的内部表征来研究。
紧凑的取证读出
先定位层与潜在锚点,再从冻结骨干的表征中进行线性分类。
查看论文原图为什么研究这个问题
将检测器作为黑箱优化,难以说明哪些已学信号支撑了泛化。内部稀疏定位使研究者能够在继续投入整模型适配之前,先分析模型已经拥有的取证知识。
方法如何工作
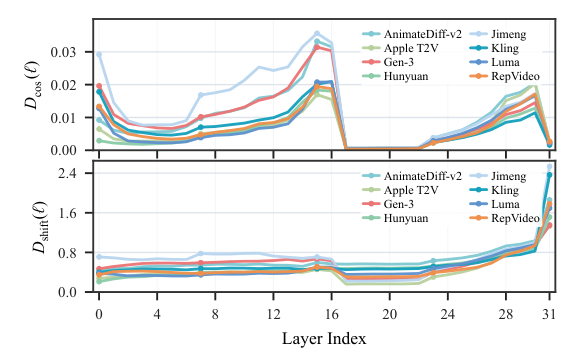
- 结合真实与伪造视频表征之间的互补差异,定位关键层。
- 在这些层中选择潜在锚点神经元,构成紧凑判别子空间。
- 冻结骨干训练线性读出,再通过外部分布和定向干预检验其作用。
定位具有判别信息的层
两类差异信号展示八个伪造来源子集中的逐层变化。
查看论文原图实验发现了什么
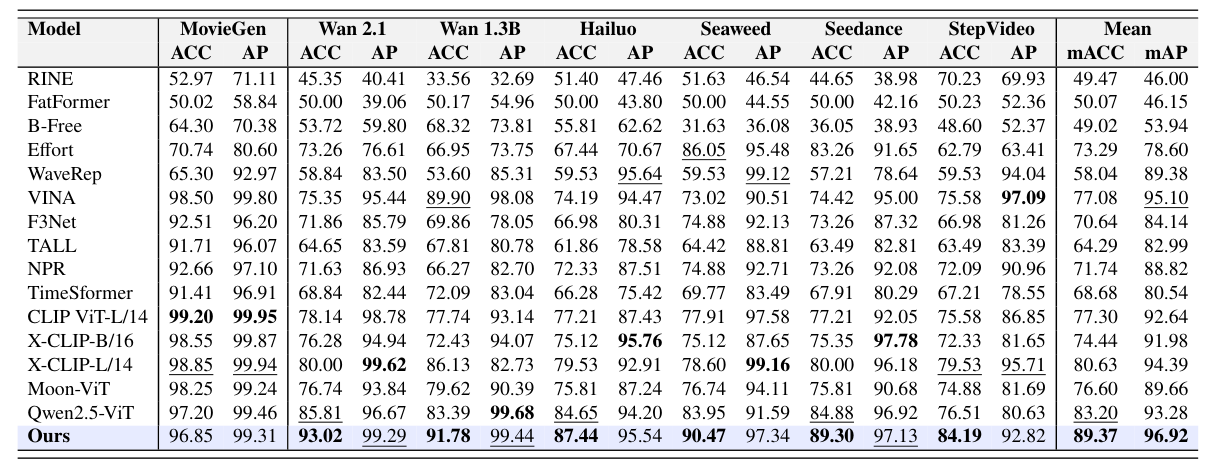
所选图表展示逐层定位信号与外部生成视频基准上的检测比较。论文还通过同预算控制、深度限制、跨架构检验及成对激活交换,分析收益是否来自选定单元本身。
发现设置之外的检测表现
原表比较外部生成视频数据集上的准确率与平均精度。
查看论文原图这项研究意味着什么
这项工作将已训练的检测器视为可检查、可复用知识的来源。稀疏读出的有效性,有助于区分表征中储存的判别能力与原分类头实际暴露出来的能力。
泛化仍取决于这些坐标捕捉了什么差异。外部生成器测试与激活交换,使这一问题能够同时从迁移范围和决策变化两个角度接受检验。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{v_find,
  title = {V-FIND: Revealing the Intrinsic Forgery Knowledge Encoded in Video Forgery Detectors},
  author = {Kan, Shichao and Hong, Chengpeng and Dou, Jingtong and Shi, Chuancheng and Liu, Yuhan and Xu, Linrui and Liang, Yixiong and Cen, Yigang and Sun, Yanpeng and Shen, Fei and Chua, Tat-Seng},
  year = {2026},
  eprint = {2608.03008},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2608.03008}
}