Circe:通过组件交互一致性实现免训练大模型自评估
读出注意力与 FFN 的跨层交互一致性,结合表征几何和输出似然,在无需参考答案或重复采样的条件下评估回答正确性。
核心内容
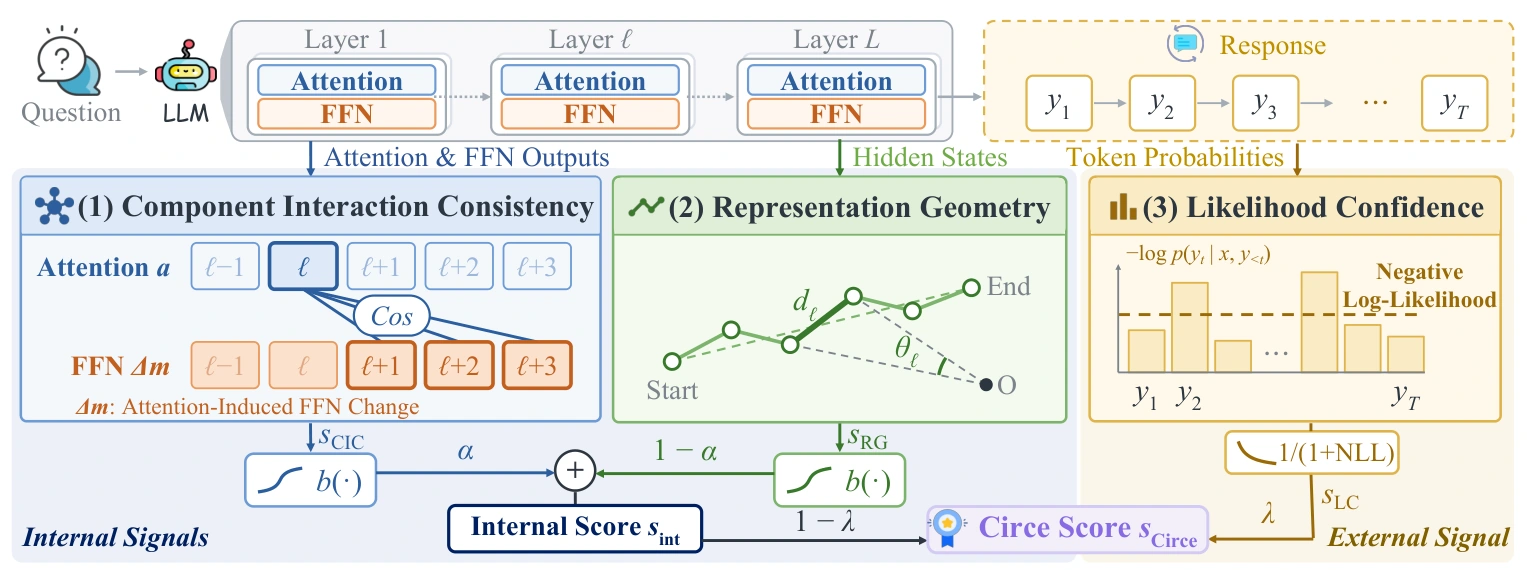
模型可能对错误答案给出很高的概率,甚至稳定地重复同一种错误。Circe 将评估视角推进到回答背后的计算过程:观察较早层的注意力更新,是否与后续层中由注意力引起的 FFN 输出变化保持方向一致,再结合表征几何与输出似然,形成回答正确性分数。
这一过程只需要一次生成,无需额外训练评估模型,评估新回答时也不需要参考答案。融合权重通过开发集选择,因此“免训练”并不等于完全不需要校准信息;区分这两点,有助于准确理解方法的使用条件。
回答是否正确,既可以从输出置信度判断,也值得从组件之间的计算协同中寻找证据。
三种互补的正确性证据
原始方法图分别展示注意力—FFN 交互一致性、隐藏状态几何与似然置信度,再将三类信号融合。
查看论文原图为什么研究这个问题
隐藏状态轨迹记录的是注意力与前馈网络作用后的合成结果,未必能够揭示组件之间如何协同。两个回答可以具有相近的输出置信度,却对应不同的内部交互模式。直接刻画这种交互,能够为正确性判断提供更具体的内部证据。
方法如何工作
- 计算组件交互一致性 CIC:比较较早层注意力更新与较晚层中注意力诱发的 FFN 输出变化之间的方向关系。
- 构建互补信号:利用归一化位移和角度变化描述表征几何 RG,将生成 token 的平均负对数似然转换为似然置信度 LC。
- 融合内部与外部信号:使用开发集选择的权重形成统一评分,在测试时无需重复采样或参考答案,即可对回答的正确性进行排序。
正确与错误回答的分数分布
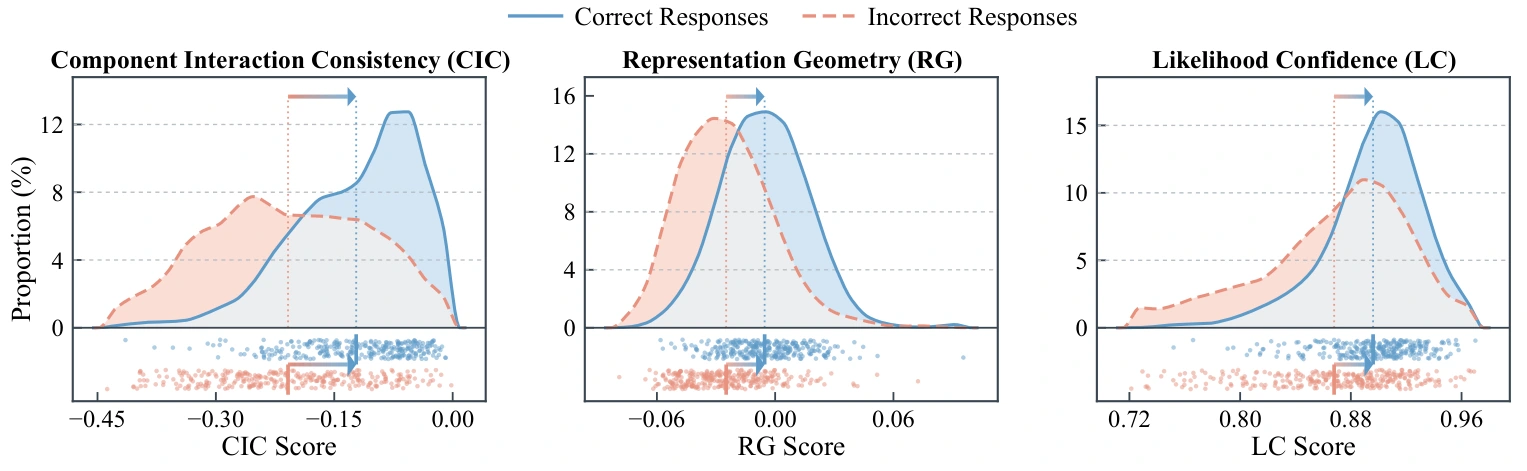
在 Qwen2-7B-Instruct 与 MATH 上,三类信号在正确回答上的均值更高,但两类分布仍存在重叠。
查看论文原图实验发现了什么
论文在五个 LLM、六个基准上评估数学、推理、知识与理解四类任务。完整方法在四个领域的平均 AUROC、FPR95 和 AUPR 上取得所比较方法中的最佳结果,并在 20 个模型—领域组合中的 18 个组合上取得最高 AUROC。
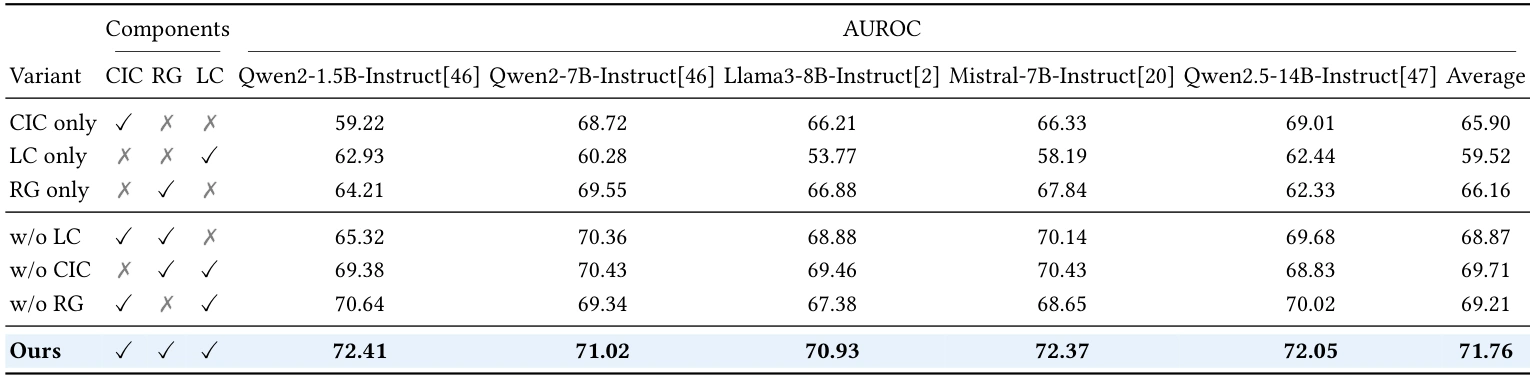
组件消融中的平均 AUROC 为 71.76%;去除 CIC 后降至 69.71%。扩展实验覆盖 11 种语言,并在视觉几何任务上报告 71.25% AUROC。上述数值衡量正确与错误回答的区分能力,并非模型回答问题的准确率。
交互一致性提供额外信息
五个模型上的完整评分平均 AUROC 为 71.76%,去除 CIC 后为 69.71%。
查看论文原图这项研究意味着什么
这项工作的关键在于:可靠性不只体现为模型“多么相信”某个答案,也可能体现为模型的不同组件如何共同支撑这一答案。交互一致性将这种协同关系转化为可测量信号,补充了整体表征轨迹与输出似然未充分表达的信息。
由此,模型评估可以进一步连接内部计算与外部行为。但一致性仍然是统计证据,不能直接等同于事实正确;其价值需要在不同任务、模型与校准条件下继续检验。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{circe,
  title = {Circe: Training-Free LLM Self-Evaluation via Component Interaction Consistency},
  author = {Miao, Shuyi and Li, Zheng and Xie, Xu and Xu, Linrui and Shen, Fei and Du, Xiaoyu and Chua, Tat-Seng},
  year = {2026},
  eprint = {2611.07948},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2611.07948}
}