正确答案是否具有稳定的潜在知识支撑?
答对是外部结果。这项研究进一步追问:改变知识的激发条件,答案背后的内部支撑是否仍然稳定?
核心内容
这项工作将“回答是否正确”与“知识能否在提问变化下保持稳定”分开考察。局部知识状态和知识之间的关系几何,提供了两种互补的稳定性视角。EpiStableBench 控制改写、格式、上下文和语言等因素,使一次正确回答与稳定知识状态之间的差距能够被系统测量。
这种视角揭示了准确率难以呈现的差异:输出同样正确的知识项,内部稳定性与后续回答表现仍可能不同。工作还探索利用潜在稳定性引导偏好优化,将内部诊断进一步连接到行为改进。
答对一次是一个观察结果;知识是否稳定,取决于支撑答案的内部表征。
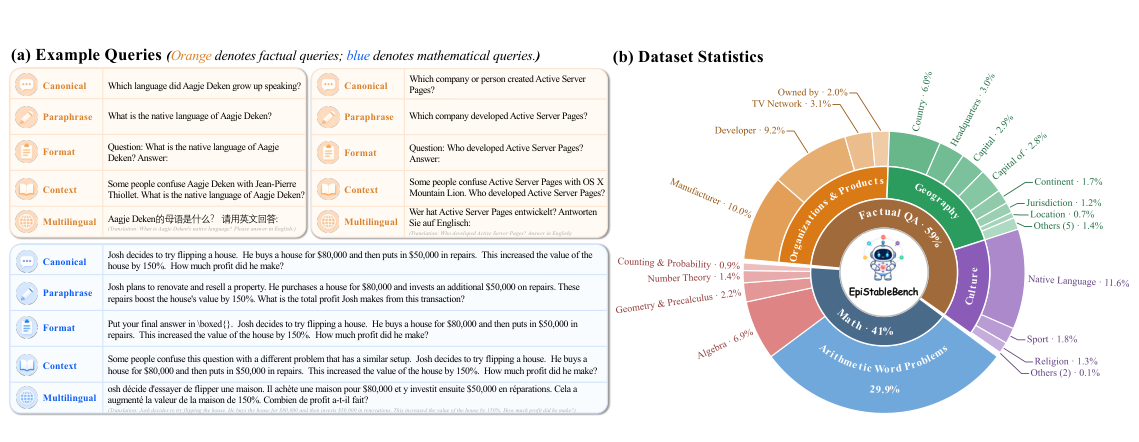
知识稳定性评估基准
EpiStableBench 控制知识项,并改变知识被调用时的提问条件。
查看论文原图为什么研究这个问题
仅统计答案是否正确,无法判断同一知识在不同条件下是否具有稳定的内部表示。通过受控地改变知识激发条件,可以把外部表现与内部支撑放在一起研究。
方法如何工作
- 分别汇总各激发条件下的内部表示,以基准条件为参照,校正不同条件之间的共享偏移。
- 用 LSS 衡量归一化后的知识状态位移;用 KTS 衡量知识项之间距离排序在不同条件下的一致性。
- 在 EpiStableBench 上开展受控评估,并通过 LatentDPO 学习考虑潜在知识稳定性的编辑策略。
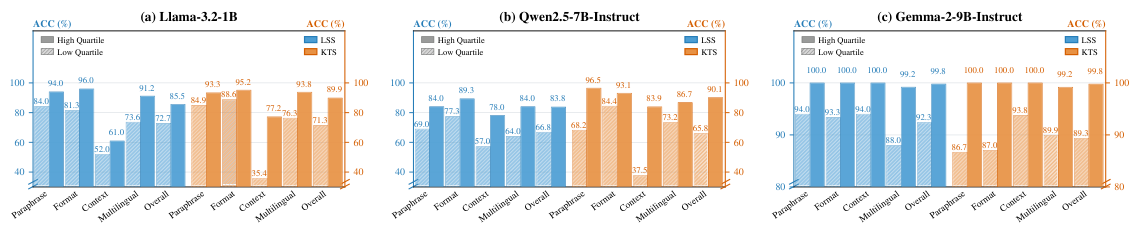
当前正确,之后是否可靠?
对初始回答正确的知识项,比较不同稳定性组在未见提问条件下的后续准确率。
查看论文原图实验发现了什么
EpiStableBench 包含 4,411 个知识项和 76,766 个受控查询,覆盖 16 个大语言模型。模型内部更稳定的知识通常对应更好的留出条件准确率,但跨模型比较时,规模或总体准确率并不稳定地预测知识稳定性。LatentDPO 在所评估的编辑方法组合中改善了编辑成功率和泛化。
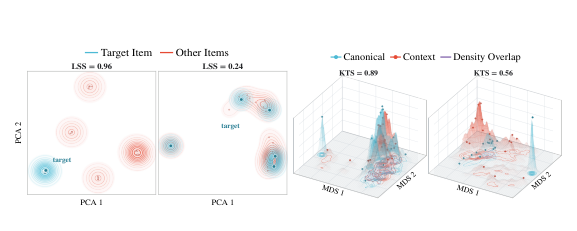
稳定性的两种几何视角
局部状态的集中程度与关系分布的重叠,从互补角度呈现内部知识稳定性。
查看论文原图这项研究意味着什么
可靠评估需要回答知识在什么条件下仍然能够被调用。一次正确输出可能掩盖对提问方式的敏感性;内部稳定性则为识别这种脆弱性、选择值得进一步检验的知识项,增加了一条观察轴。
更长远的方向,是把表征结构、知识调用条件和最终行为放在同一条证据链中研究。不同模型的几何尺度需要分别校准,因此稳定性指标更适合作为可靠性诊断信号,其本身并不构成答案真实性的保证。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{latent_support,
  title = {Do correct answers have stable latent knowledge support?},
  author = {Shi, Chuancheng and Li, Shangze and Wu, Wenhua and Hu, Kun and Shen, Fei and Wang, Zhiyong and Chua, Tat-Seng},
  year = {2026},
  eprint = {2610.15277},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2610.15277}
}