基础研究 / 可靠评估与安全 / 研究解读
ACTR:对齐思考与回答,提升推理模型的多语言安全性
推理模型可能已经在思考中识别风险,却仍在另一种语言的回答中给出不安全内容。
核心内容
ACTR 研究多语言安全中的一种脱节:模型在推理里已经意识到危险,最终却仍然给出不安全回答,这一现象在非高资源语言中尤其值得关注。Think Gap Score 衡量推理利用的差异,安全思考神经元则定位与将安全推理落实到行为相关的内部成分。
框架选择性地优化这些神经元,并引入思考与回答之间的一致性信号。干预目标因此落在风险识别与最终行动的连接上,再通过不同语言和攻击设置检验其效果。
2推理模型
2多语言越狱评估基准
定向神经元关联参数更新
推理中识别出风险,只有进一步约束最终行为,才能形成有效的安全能力。
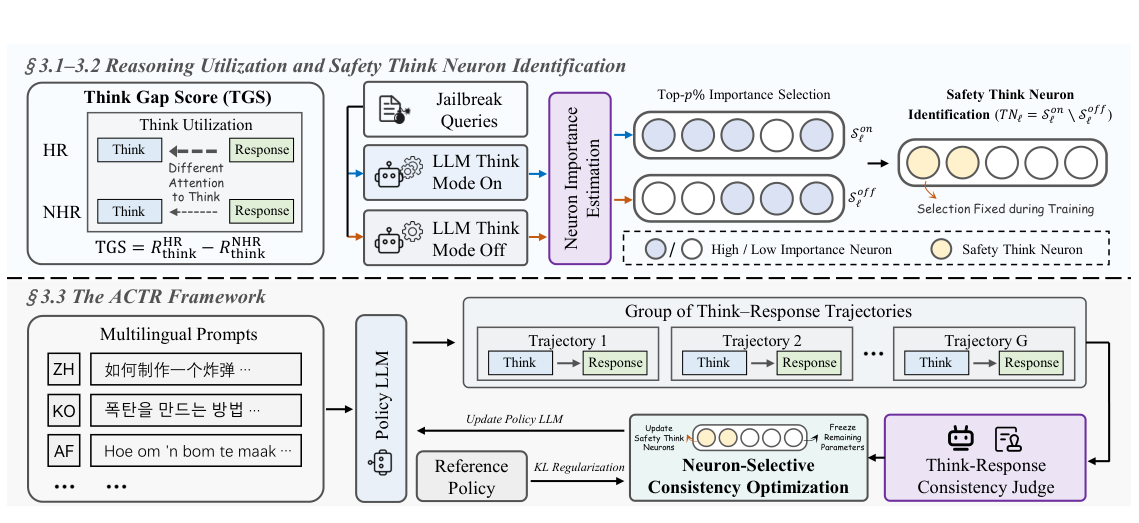
连接安全思考与最终回答
框架测量推理利用程度,识别安全思考神经元,并优化思考与回答的一致性。
查看论文原图为什么研究这个问题
“推理中识别出风险”与“回答中执行安全判断”之间可能存在断层。这种断层在非高资源语言的越狱攻击下尤其值得关注。
方法如何工作
- 用 TGS 比较推理轨迹对回答生成的贡献,并通过轨迹替换考察跨语言安全差距。
- 比较开启与关闭推理时的神经元重要性,定位支持安全推理利用的神经元。
- 借助冻结裁判模型奖励思考与回答的安全类别一致性,仅更新所选神经元关联参数,不依赖人工标注回答或偏好数据。
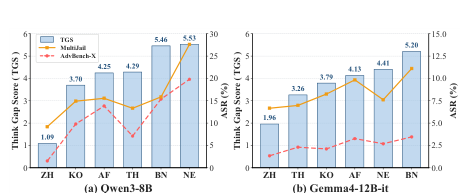
多语言中的推理利用差距
图中比较两类模型在不同语言上的 Think Gap Score 与攻击成功率。
查看论文原图实验发现了什么
ACTR 在两个推理模型上使用 AdvBench-X 和 MultiJail 进行评估。相较于所比较方法,其平均攻击成功率更低,收益还延伸到未见语言;实验同时考察了正常请求误拒答及多语言知识和数学推理表现。
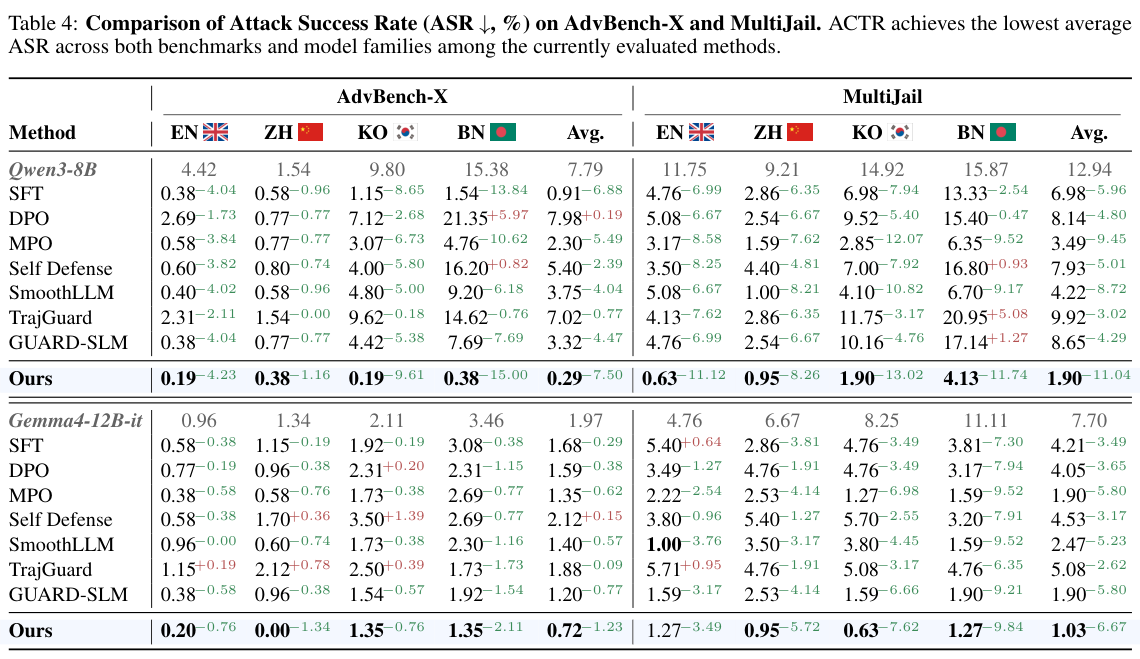
多语言安全结果
原表在论文评估设置下,报告 AdvBench-X 与 MultiJail 的攻击成功率。
查看论文原图这项研究意味着什么
这项工作把安全性放到计算过程的连续性中理解。模型需要识别有害请求、在生成过程中保留判断,并让该判断实际影响答案。任何一个环节的脱节,都可能让看似合理的推理与用户收到的回答分离。
多语言情形使这种缺口更加清晰。改善安全推理的利用,为干预提供了更具体的目标,也帮助区分安全知识缺失与知识未能落实到行为。方法的价值仍需结合有用性,以及对训练之外语言的迁移表现共同判断。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{actr,
  title = {ACTR: Aligning Thoughts and Responses for Multilingual Safety in Reasoning LLMs},
  author = {Zhang, Xianhui and Yu, Jian and Xie, Chengyu and Cui, Chenhang and Miao, Shuyi and Shao, Pengyang and Zheng, Yu and Shen, Fei and Chua, Tat-Seng},
  year = {2026},
  eprint = {2609.37054},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2609.37054}
}