基础研究 / 机制理解 / 研究解读
能解码,不等于有视觉依据:VLM 空间推理的视觉消融裁决
通过图像消融,区分视觉依据、方向先验与被错误使用的表征。
核心内容
这项研究检验一种常见的可解释性证据组合:探针能够读出答案,表征引导又能改善表现。在 VLM 空间推理中,即使图像被替换为空白,这种“恢复”也可能继续存在,因而高估视觉依据。
视觉消融裁决进一步区分三种情形:有视觉依据且使用正确、不依赖视觉的方向先验,以及依赖视觉却反向使用的部署。在第三种情形中,信息既能被解码、也能被干预控制,模型却以错误符号使用相关方向。
14分析覆盖的 VLM
6语言模型家族
三类状态视觉依据、先验与反向使用
能够解码或引导一种表征,并不足以证明模型依赖图像作出了决策。
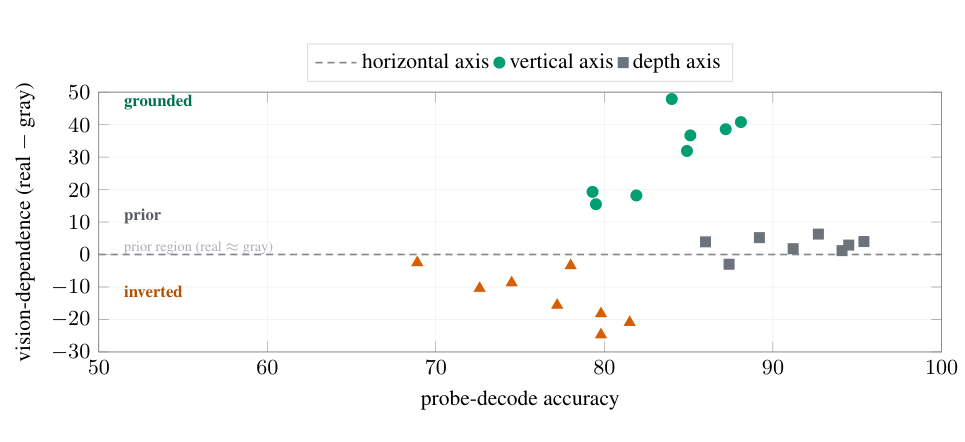
可解码性与视觉依赖可能分离
每个点将探针准确率与移除图像后的行为变化联系起来。
查看论文原图为什么研究这个问题
模型可能暴露可线性解码的标签,却没有在实际计算中使用预期证据。证明表征存在且能够改变输出之后,还需要继续回答:这种行为影响是否依赖视觉输入?
方法如何工作
- 联合比较空间任务行为、探针可解码性与受控表征干预。
- 保持任务不变,使用空白图像及其他视觉消融对照,检验对输入证据的依赖。
- 区分视觉依据状态,并研究修正反向使用所需的最小表征编辑。
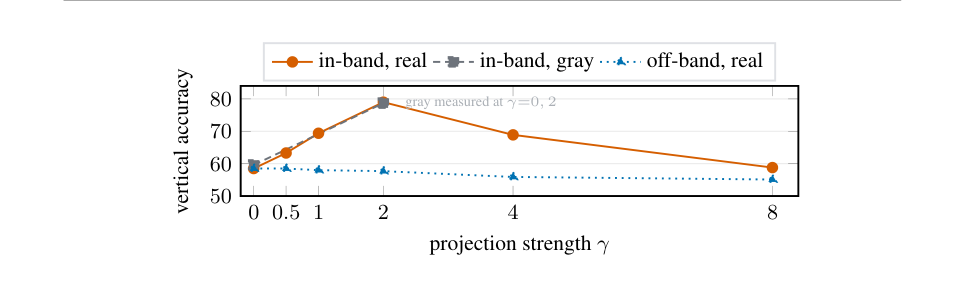
引导是否恢复了视觉证据?
对比真实与空白图像下的引导结果,检验收益是否依赖视觉。
查看论文原图实验发现了什么
研究覆盖六类语言模型家族中的十四个 VLM,并按空间轴区分视觉依据状态。其他实验比较多种视觉消融,检验跨模型的解码—使用反向现象;修正方式随表征几何变化,从无需训练的旋转到学习得到的低秩编辑有所不同。
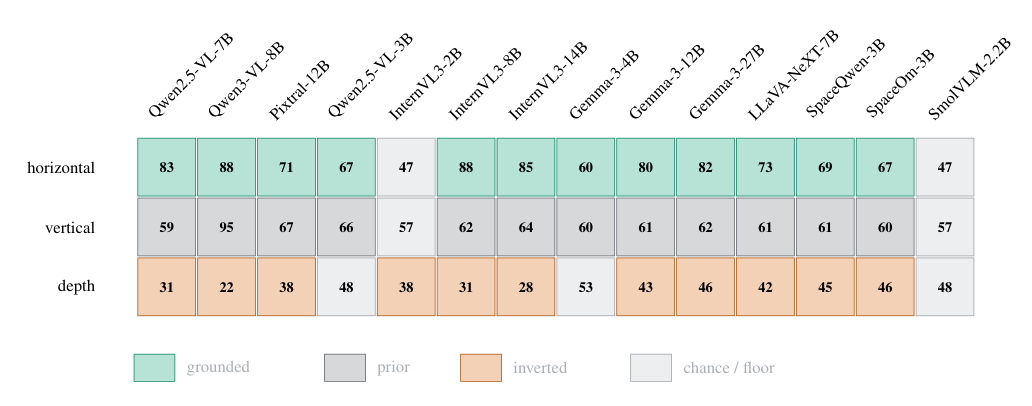
跨模型的视觉依据卡片
原始矩阵总结十四个 VLM 在不同空间轴上的行为与视觉依据状态。
查看论文原图这项研究意味着什么
这项工作区分了四类容易混淆的证据:信息能被解码、输出能被干预控制、答案能够正确,以及决策确实依赖图像。更有说服力的潜在知识解释,需要明确自己已经验证了其中哪些环节。
一个简单反事实因而很有价值:移除视觉证据,可以挑战原本看似充分的探针与引导结论;其他消融则检验结果是否只是空白输入的特殊效应。更广泛的启发,是将视觉依据视为实际计算中需要测量的性质。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{decodable_not_grounded,
  title = {Decodable Is Not Grounded: A Vision-Ablation Arbiter for VLM Spatial Reasoning},
  author = {Liao, Chih-Ting and Shen, Fei and Cao, Xin and Chua, Tat-Seng},
  year = {2026},
  eprint = {2606.31257},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2606.31257}
}