基础研究 / 能力激发与迁移 / 研究解读
ReflectRL:从专家失败轨迹中学习,将反思迁移为直接推理
将专家失败轨迹转化为反思材料,再通过策略过渡把收益迁移到直接推理。
核心内容
ReflectRL 研究专家模型在困难问题上的失败轨迹。轨迹即使不能作为正确示范,也可能保留部分有效路线,使检查和修复比从头求解更容易;工作将这种现象称为反思优势。
框架先利用这些“黄金负轨迹”引导反思推理,再将策略过渡回直接推理,由此区分训练时有用的信息与模型独立回答时需要形成的行为。
9评估基准
4语言模型骨干
4同策略训练方法
当学习目标鼓励修复错误时,一条失败的专家轨迹仍可能保留有用结构。
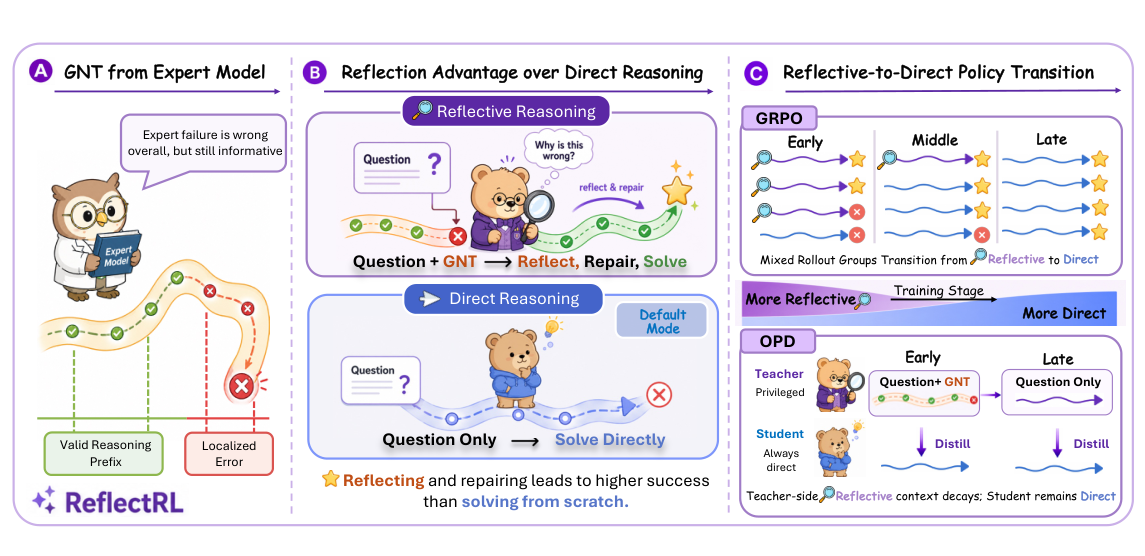
从失败指导到独立推理
框架结合黄金负轨迹、反思推理与向直接推理的策略过渡。
查看论文原图为什么研究这个问题
轨迹引导训练往往会在专家也遇到困难的问题上失去监督。丢弃全部失败尝试,可能同时丢掉能够帮助学习者定位并解决难点的中间推理结构。
方法如何工作
- 收集专家失败轨迹,将其作为反思材料,而非模仿目标。
- 在同策略训练中结合反思与直接推理。
- 通过反思到直接推理的策略过渡,使收益迁移到不依赖轨迹指导的回答。
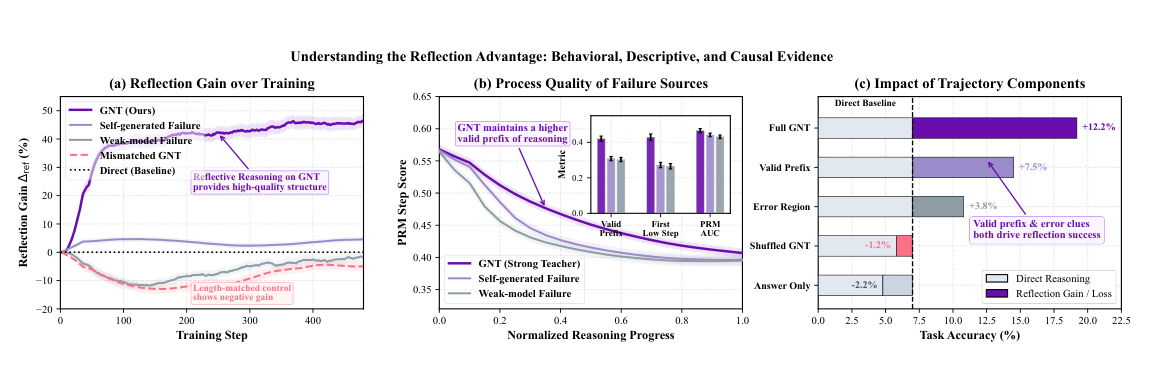
检验反思优势
行为、描述与干预分析共同考察失败轨迹提供了什么信息。
查看论文原图实验发现了什么
实验覆盖九个基准、四类语言模型骨干和四种同策略训练方法。行为与干预分析考察反思优势,训练动态、模块消融及策略过渡比较则检验指导如何影响学习与后续直接推理。
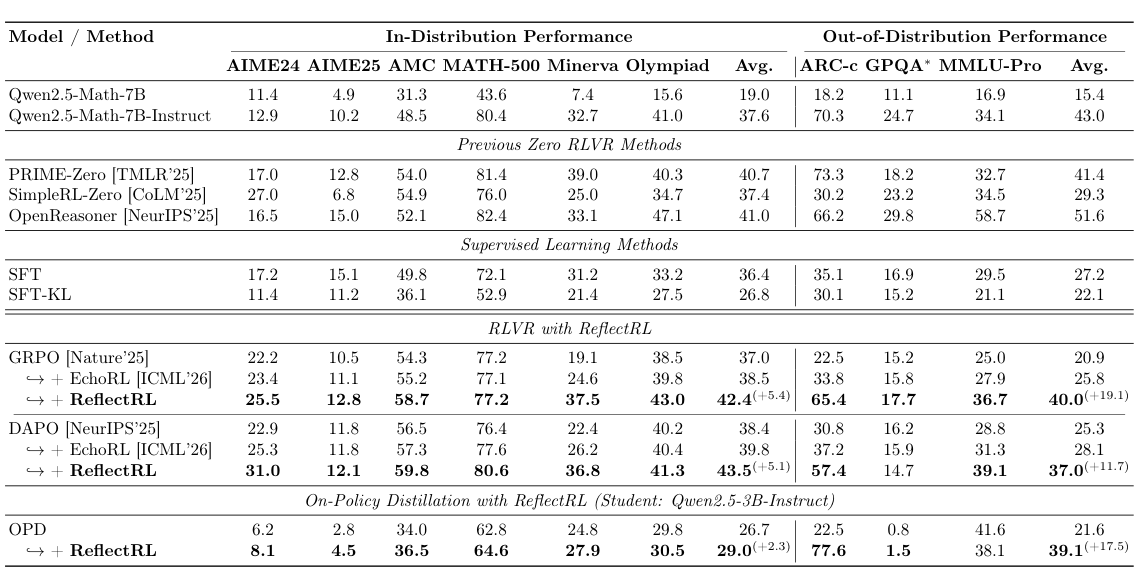
分布内与未见任务表现
原表比较是否加入 ReflectRL 时的分布内与分布外基准表现。
查看论文原图这项研究意味着什么
这项工作将负样本从一个失败标签,扩展为可能包含可复用结构的研究对象。学习可以进一步回答:哪些部分仍有信息,错误发生在哪里,成功的后续推理又需要改变什么?
策略过渡处理了第二个关键问题:额外上下文应当提升模型自身能力。联合考察两个阶段,有助于区分读取专家尝试带来的收益,与已经保留在模型独立推理中的收益。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{reflectrl,
  title = {ReflectRL: Learning from Golden Negative Trajectories via Reflective-to-Direct Reasoning},
  author = {Bi, Jinhe and Zhou, Chennan and Jin, Zengjie and Aniri and Lu, Shuo and Huang, Wenke and Cao, Hu and Xiao, Xun and Zhu, Zhihong and Tresp, Volker and Shen, Fei and Ma, Yunpu and Chua, Tat-Seng},
  year = {2026},
  eprint = {2608.03972},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2608.03972}
}