应用研究 / 应用研究 / 研究解读
ContractLens:利用潜在安全知识检测恶意智能合约
定位模型中的潜在安全信号,利用紧凑的内部神经单元表示检测恶意智能合约。
核心内容
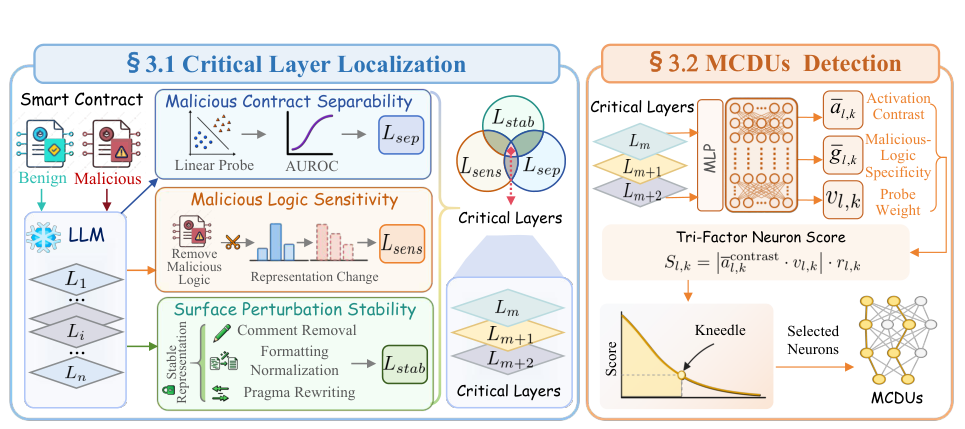
ContractLens 依据这两个要求,在冻结语言模型中定位恶意合约检测单元。它比较移除恶意逻辑与保留行为的格式、注释等修改所产生的影响,选择既能区分恶意行为、感知其移除,又能抵抗无关变化的关键层与神经元。
选出的单元被用于轻量检测器。特征选择由此围绕安全语义展开,使内部测量能够服务于一个对表面捷径尤其敏感的真实任务。
3预训练模型
MCDU恶意合约判别单元
冻结语言模型主干
安全表征应当对恶意逻辑的变化敏感,同时对无关表面变化保持稳定。
检测单元的语义检验
流程结合恶意逻辑敏感性、表面稳定性与可分性,选择关键层和单元。
查看论文原图为什么研究这个问题
提示式审计能够获得模型判断,却难以直接说明判断所依赖的内部表示。ContractLens 关注哪些信号与恶意逻辑有关,以及它们能否在代码表面形式变化后保持稳定。
方法如何工作
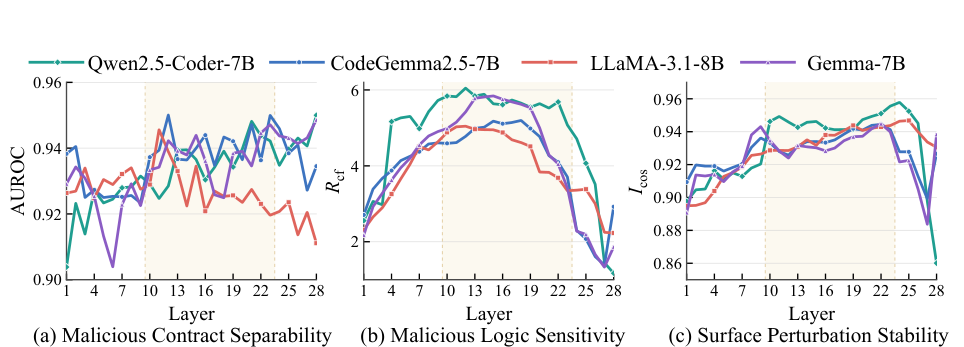
- 先用逐层线性探针识别候选层,再检验移除恶意逻辑时的敏感性,以及行为保持的表面修改下的稳定性。
- 融合激活对比、恶意逻辑特异性和探针权重,形成三因素重要性得分,并利用排序曲线的拐点选取单元。
- 拼接所选单元的激活,构造紧凑表示,用于训练轻量检测器。
哪些层满足定位标准?
逐层测量展示不同语言模型在三项定位标准上的变化。
查看论文原图实验发现了什么
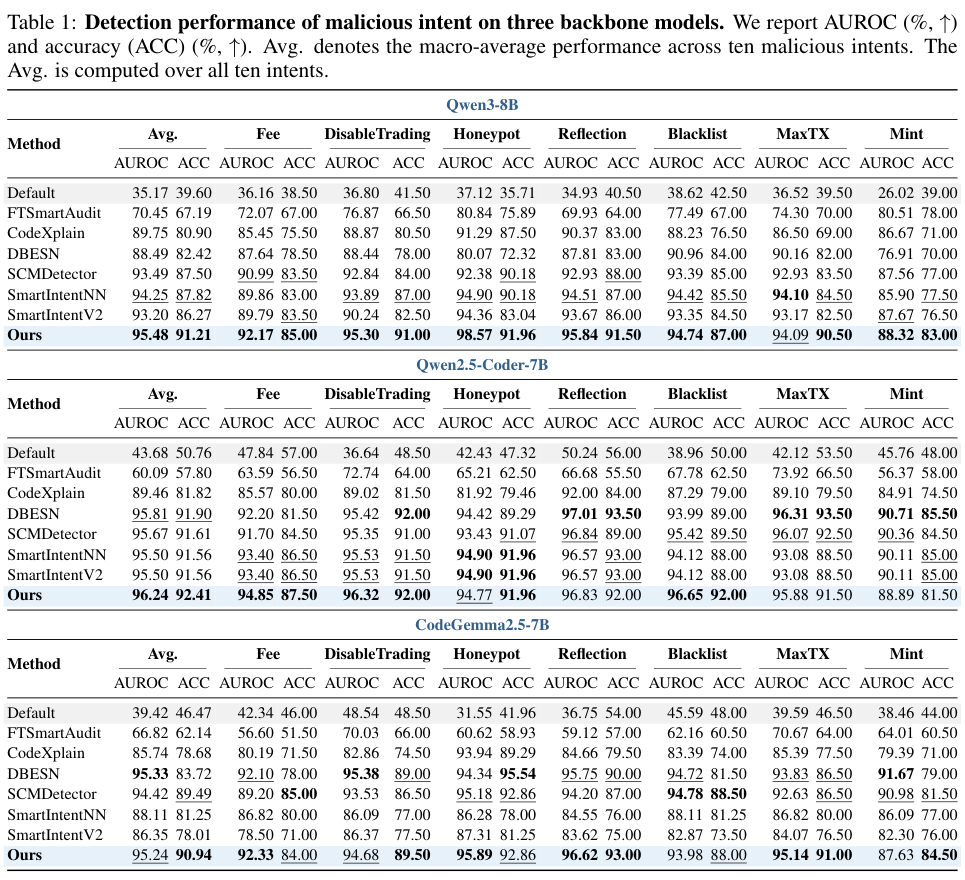
屏蔽 MCDU 导致的检测性能下降,大于随机单元及激活幅度匹配单元的对照。三个预训练模型上的评估报告了相对所比较方法更高的平均准确率,并进一步检验了未见恶意意图与少标注分类器设置。
跨模型与恶意意图的检测
原表比较不同骨干和恶意意图下的检测表现,报告 AUROC 与准确率。
查看论文原图这项研究意味着什么
这项工作的洞见也体现在安全证据应当如何建立:当一个特征会因为任务真正关心的因素而变化时,它的预测能力才更有解释力。恶意逻辑修改与表面修改构成的对照,让这种要求成为可以量化检验的标准。
这一思路为审查检测器是否使用任务相关表征提供了路径,也适用于标签有限和恶意意图变化的情形。面向部署,还需要持续检验恶意行为覆盖范围,以及用于验证语义敏感性的代码修改是否忠实保留了预期语义。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{contractlens,
  title = {ContractLens: Latent Security Knowledge for Malicious Smart Contract Detection},
  author = {Miao, Shuyi and Huang, Xinyi and Qiu, Wangjie and Shen, Fei and He, Jinchun and Zheng, Zhiming and Chua, Tat-Seng},
  year = {2026},
  eprint = {2610.04992},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2610.04992}
}