应用研究 / 应用研究 / 研究解读
LAKE:挖掘视觉语言模型中的潜在异常知识
利用少量正常样本,挖掘视觉语言模型中已经存在的异常敏感神经元。
核心内容
LAKE 利用少量正常图像,在冻结视觉语言模型中定位异常敏感单元,再将局部结构偏离与跨模态语义信号结合为异常分数。骨干提供已有表征,正常样本则帮助确定应当怎样读取这些表征。
这一方法把内部定位与异常检测连接起来,无需基于梯度适配骨干。定量评估与空间异常图共同检验,选出的信号能否识别陌生缺陷并定位异常区域。
稀疏敏感神经元表示
正常样本用于信号定位的样本
0主干梯度更新
正常样本能够帮助定位预训练表征中对异常真正有诊断价值的部分。
读取异常敏感知识
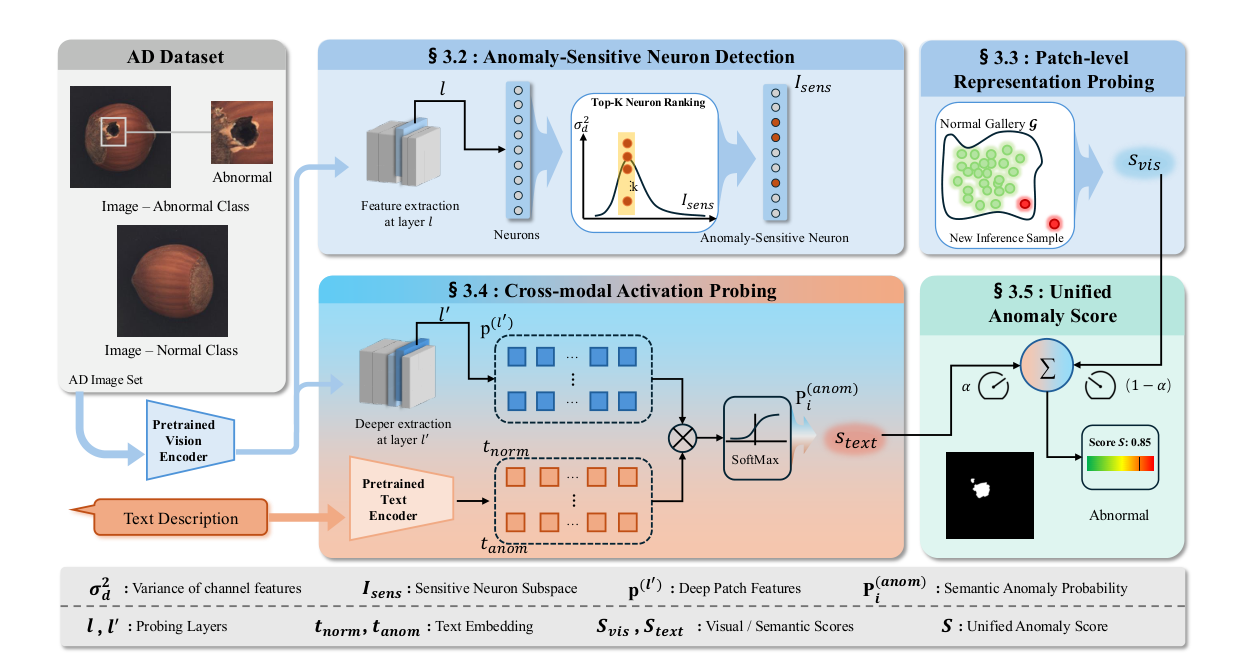
正常样本用于选择敏感单元,结构与语义信号共同形成异常分数。
查看论文原图为什么研究这个问题
将视觉语言模型作为黑箱特征提取器,难以解释哪些内部信号真正支持异常判断。LAKE 进一步研究这些信号能否被直接筛选和激发。
方法如何工作
- 利用少量正常样本,在预训练模型中识别对异常变化敏感的神经元。
- 分离选中的神经信号,构造紧凑的正常性表示。
- 联合视觉结构偏离与跨模态语义激活,用于异常评分。
观察异常出现的位置
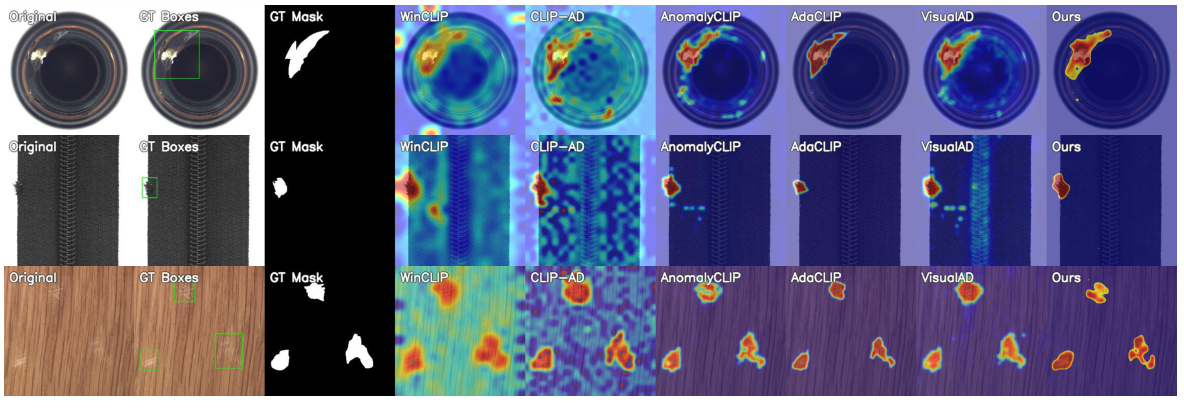
原始定位图将预测异常区域与真实掩码及基线方法进行比较。
查看论文原图实验发现了什么
工业异常检测基准上的评估报告了较强的检测表现,并提供神经元层面的内部解释。其方法使用正常样本,侧重既有内部信号的筛选与利用,而非重新训练主干。
正常支持样本的作用
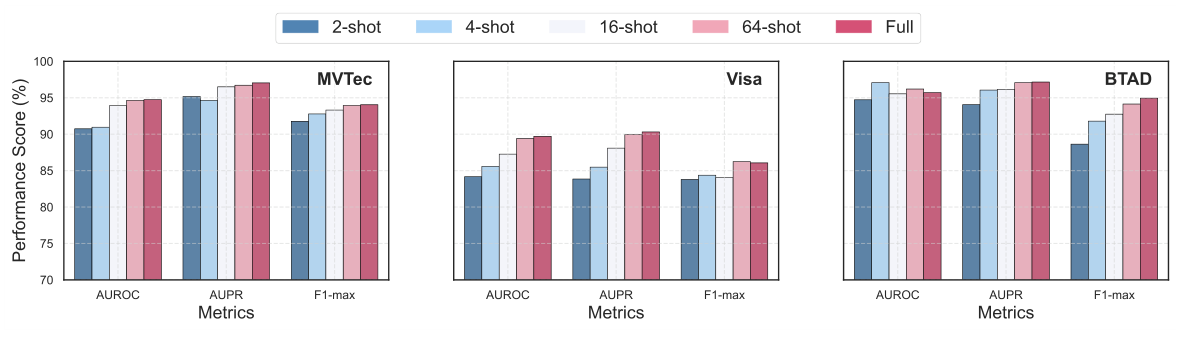
消融实验比较正常支持集规模增加时的图像级异常检测表现。
查看论文原图这项研究意味着什么
缺陷样本有限,是异常检测长期面对的任务条件。系统需要从正常状态中提取足够的诊断依据;LAKE 将其具体化为在恰当的内部位置选择和读取预训练知识。
这也为少样本适配提供了可解释的研究路径:正常样本选中了哪些单元、这些单元识别何种偏离、支持集规模又怎样影响结果。围绕这些问题展开分析,也有助于判断预训练知识何时不足以支持新的检测环境。
论文与相关资源
本文为论文介绍,方法定义、实验设置与完整结果请参见论文原文。
引用这项研究
@misc{lake,
  title = {Latent Anomaly Knowledge Excavation: Unveiling Sparse Sensitive Neurons in Vision-Language Models},
  author = {Li, Shaotian and Li, Shangze and Shi, Chuancheng and Wu, Wenhua and Wu, Yanqiu and Yu, Xiaohan and Shen, Fei and Chua, Tat-Seng},
  year = {2026},
  eprint = {2604.07802},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2604.07802}
}